Una organización puede tener UPS, grupo electrógeno, climatización de respaldo y equipos duplicados y, aun así, conservar un punto capaz de detener toda la operación.
La razón es sencilla: la redundancia de un componente no garantiza la redundancia del sistema completo.
Dos equipos pueden parecer independientes y depender de un mismo tablero. Un generador puede estar disponible, pero la energía de respaldo puede atravesar un único elemento de transferencia. Dos unidades de climatización pueden compartir alimentación, control o una condición de instalación cuya falla afecte a ambas.
A estas dependencias se las conoce como puntos únicos de falla: elementos cuya pérdida puede interrumpir una función crítica porque no existe una ruta alternativa capaz de mantenerla.
Identificarlos antes de una contingencia exige mirar la infraestructura como un recorrido completo y no como una colección de equipos.
Tabla de Contenidos
¿Qué es un punto único de falla?
Un punto único de falla, o single point of failure (SPOF), es un componente, conexión, recurso o dependencia cuya falla puede dejar sin servicio a una función porque no dispone de una alternativa efectiva.
Puede ser un equipo, pero también algo menos evidente:
- una alimentación eléctrica;
- un tablero;
- una protección;
- una transferencia;
- un tramo de distribución;
- una bomba;
- una tubería;
- un controlador;
- una comunicación;
- un sensor compartido;
- una condición física común.
El concepto obliga a cambiar la pregunta. En vez de preguntar únicamente “¿tenemos respaldo?”, conviene preguntar “¿qué tendría que fallar para que el respaldo deje de llegar hasta la carga?”
Tener dos equipos no siempre significa tener redundancia
La duplicación es visible. Las dependencias compartidas no siempre lo son.
Imagine dos UPS destinadas a proteger una carga crítica. Sobre el papel existen dos equipos. Pero si ambas reciben energía desde un único tablero sin una alternativa prevista, ese tablero puede convertirse en una dependencia común.
Algo similar ocurre con dos equipos de climatización conectados a una misma alimentación o con dos rutas que terminan pasando por un mismo componente antes de llegar a la carga.
La redundancia real debe seguirse de extremo a extremo. Si dos caminos vuelven a unirse en un elemento sin respaldo, ese punto merece atención.
Puntos únicos de falla en el sistema eléctrico
En una infraestructura con respaldo eléctrico, el análisis puede comenzar desde la fuente y seguir el recorrido hasta la carga.
No basta con comprobar la presencia de una UPS o un grupo electrógeno. Conviene revisar qué elementos existen antes, entre y después de ellos.
Algunas dependencias pueden aparecer en:
- acometida y distribución de entrada;
- tableros;
- interruptores y protecciones;
- sistemas de transferencia;
- UPS y sus bypass;
- distribución posterior a la UPS;
- circuitos que finalmente alimentan la carga.
Un grupo electrógeno operativo, por ejemplo, no protege una carga si una falla impide transferir o distribuir su energía hasta ella.
Por eso la disponibilidad debe evaluarse como una cadena.
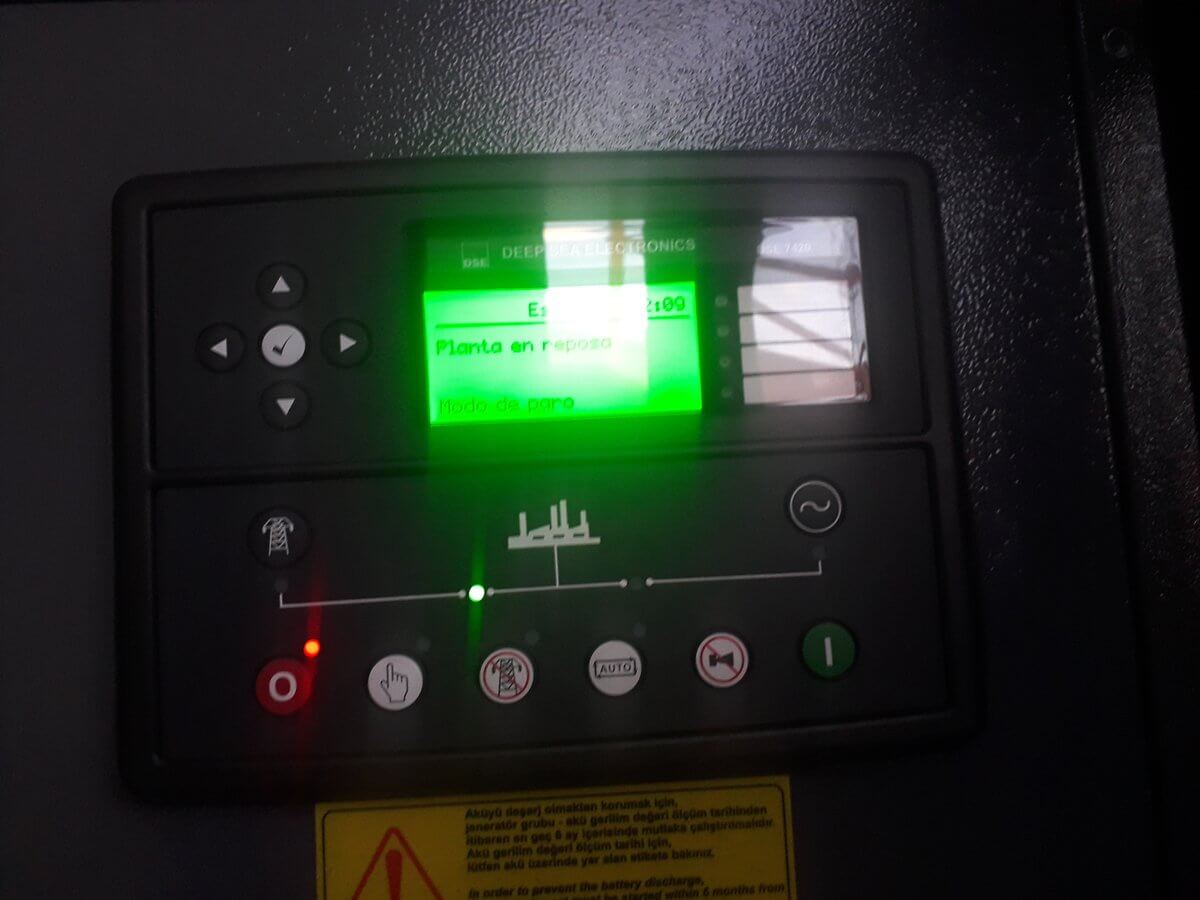
El sistema de transferencia puede ser tan importante como el generador
Cuando falla la fuente normal, la infraestructura necesita detectar la condición, arrancar el respaldo cuando corresponda y transferir la carga mediante la arquitectura prevista.
En ese proceso intervienen elementos de control y potencia.
Si existe un único camino de transferencia y este queda indisponible, disponer de generación de respaldo no garantiza por sí solo que la carga reciba energía.
Esto no significa que toda instalación deba duplicar cada componente. La arquitectura necesaria depende de la criticidad, el nivel de disponibilidad buscado y los recursos de la organización. Lo importante es conocer dónde existen dependencias y qué consecuencia tendría perderlas.
También existen puntos únicos de falla en climatización
La continuidad de una sala crítica puede depender tanto de la climatización como de la alimentación eléctrica.
Instalar dos unidades de aire acondicionado puede aportar redundancia, pero conviene analizar qué comparten. Una alimentación común, un tablero, un controlador central o determinados elementos auxiliares pueden afectar simultáneamente a más de una unidad.
También importa la capacidad disponible. Si una unidad falla, la restante debe ser capaz de mantener las condiciones requeridas bajo las condiciones previstas para la instalación. Tener dos equipos no garantiza automáticamente que uno pueda asumir la función del otro.
Por eso la redundancia en climatización debe comprobarse desde la fuente de energía hasta la capacidad efectiva de mantener el ambiente.
Dependencias ocultas en control y monitoreo
Un sistema puede disponer de varios equipos físicos y depender de un único elemento de control.
Controladores, interfaces de comunicación, redes de gestión, sensores o fuentes auxiliares pueden concentrar funciones que no resultan evidentes al observar únicamente los equipos principales.
El monitoreo merece una distinción adicional. Perder una plataforma de supervisión no siempre significa perder inmediatamente el servicio físico, pero sí puede eliminar la capacidad de detectar una degradación o responder oportunamente a una falla.
Por eso conviene diferenciar entre un punto cuya falla detiene directamente la operación y otro cuya pérdida reduce la capacidad de detectar, administrar o recuperar el sistema.
Las dependencias comunes son especialmente importantes
Uno de los errores más fáciles de cometer es analizar cada sistema por separado.
Una UPS y un aire acondicionado pueden ser técnicamente independientes, pero ambos pueden depender del mismo tablero. Dos generadores pueden compartir combustible, ventilación o una condición de instalación común. Dos rutas de cableado pueden atravesar el mismo espacio físico.
En estos casos aparece una causa común de falla: un solo evento puede afectar varios elementos que parecían redundantes.
Incendio, ingreso de agua, temperatura extrema, error de operación o pérdida de una alimentación compartida son ejemplos de condiciones que pueden superar la redundancia si todos los caminos están expuestos al mismo evento.
La independencia física y funcional importa tanto como la cantidad de equipos.
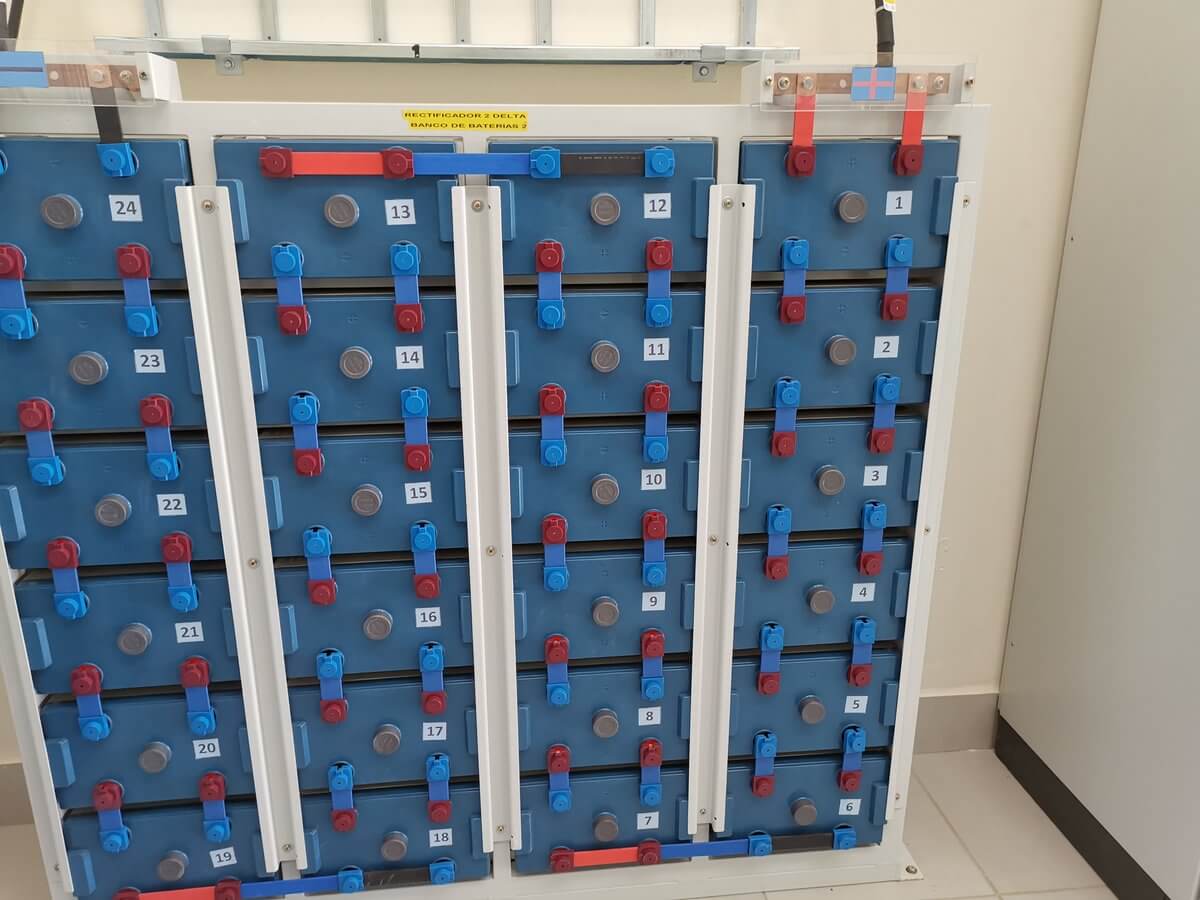
Cómo identificar puntos únicos de falla
Una revisión útil puede realizarse siguiendo el servicio desde su origen hasta la carga.
1. Definir qué función no puede interrumpirse
El análisis debe partir de la operación, no del equipo.
¿Qué debe permanecer disponible? Puede ser una carga eléctrica, una sala, un proceso, comunicaciones o una combinación de servicios.
2. Dibujar el recorrido completo
Conviene representar cómo llega cada servicio a la función crítica.
En energía, desde las fuentes hasta la carga. En climatización, desde la alimentación y las unidades hasta el ambiente. En monitoreo, desde los sensores y tarjetas hasta la plataforma que recibe la información.
Un diagrama sencillo suele revelar dependencias que una lista de equipos no muestra.
3. Preguntar qué ocurre si cada elemento desaparece
Para cada componente o conexión, la pregunta es directa:
Si este elemento falla ahora, ¿existe otro camino capaz de mantener la función?
Si la respuesta es no, se ha identificado una dependencia que debe evaluarse.
4. Buscar elementos compartidos
Después de revisar cada ruta por separado, hay que buscar lo que comparten.
Tableros, protecciones, canalizaciones, controles, alimentación auxiliar, espacios físicos y otros recursos comunes pueden convertir dos rutas aparentes en una sola dependencia real.
5. Comprobar que la alternativa funciona
Una ruta alternativa que nunca ha sido probada puede ofrecer una seguridad solo teórica.
Las pruebas funcionales, realizadas bajo procedimientos adecuados y sin comprometer la operación, ayudan a comprobar que transferencias, bypass, equipos de respaldo y secuencias de recuperación responden como se espera.
No todos los puntos únicos de falla se eliminan
Eliminar cada dependencia puede ser técnica o económicamente inviable.
La gestión comienza por identificarlas y comprender su impacto. Después puede decidirse si corresponde incorporar redundancia, modificar una ruta, mantener un repuesto, reforzar el mantenimiento, mejorar el monitoreo o preparar un procedimiento de recuperación.
La prioridad dependerá de la consecuencia de la falla y de los requisitos de continuidad de cada organización.
Un punto único de falla conocido puede gestionarse. Uno desconocido suele aparecer recién cuando algo deja de funcionar.
La infraestructura debe evaluarse como sistema
La disponibilidad no depende solamente de que cada UPS, generador o equipo de climatización se encuentre en buen estado. También depende de cómo esos elementos están conectados y de las dependencias que existen entre ellos.
Una revisión enfocada exclusivamente en equipos puede confirmar que cada componente funciona y, al mismo tiempo, pasar por alto el elemento común que podría dejar a todos sin servicio.
Analizar recorridos, dependencias y modos de falla permite pasar de una visión basada en componentes a una visión de continuidad operativa.
All Service C&C trabaja con sistemas de energía, respaldo y climatización asociados a infraestructura crítica. Una evaluación integral permite observar no solo el estado individual de los equipos, sino también las conexiones y dependencias que determinan si el respaldo estará realmente disponible cuando ocurra una interrupción.